Hipótesis múltiples
Inferencia Causal
Centro de Investigación y Docencia Económicas
Maestría en Economía
Hipótesis múltiples
Hipótesis múltiples
Error tipo I: en nuestro contexto es concluir que hay un efecto causal cuando la \(H_0\) es verdadera, es decir, cuando \(H_0:\;\beta_i=0\)
En una investigación fijamos \(\alpha\), la probabilidad de rechazar \(H_0\) cuando \(H_0\) es cierta
En economía trabajamos con \(\alpha=0.05\) o \(\alpha=0.01\)
El problema con probar múltiples hipótesis es que inflamos la tasa de error tipo I
- Por ejemplo, si tenemos 100 hipótesis en las que la \(H_0\) es cierta y si usamos un valor estándar de \(\alpha=0.05\), esperaríamos rechazar 5 hipótesis por suerte
Hipótesis múltiples
Si realizamos una prueba, la probabilidad de cometer un error es \(\alpha\) y la de no cometer un error es \(1-\alpha\)
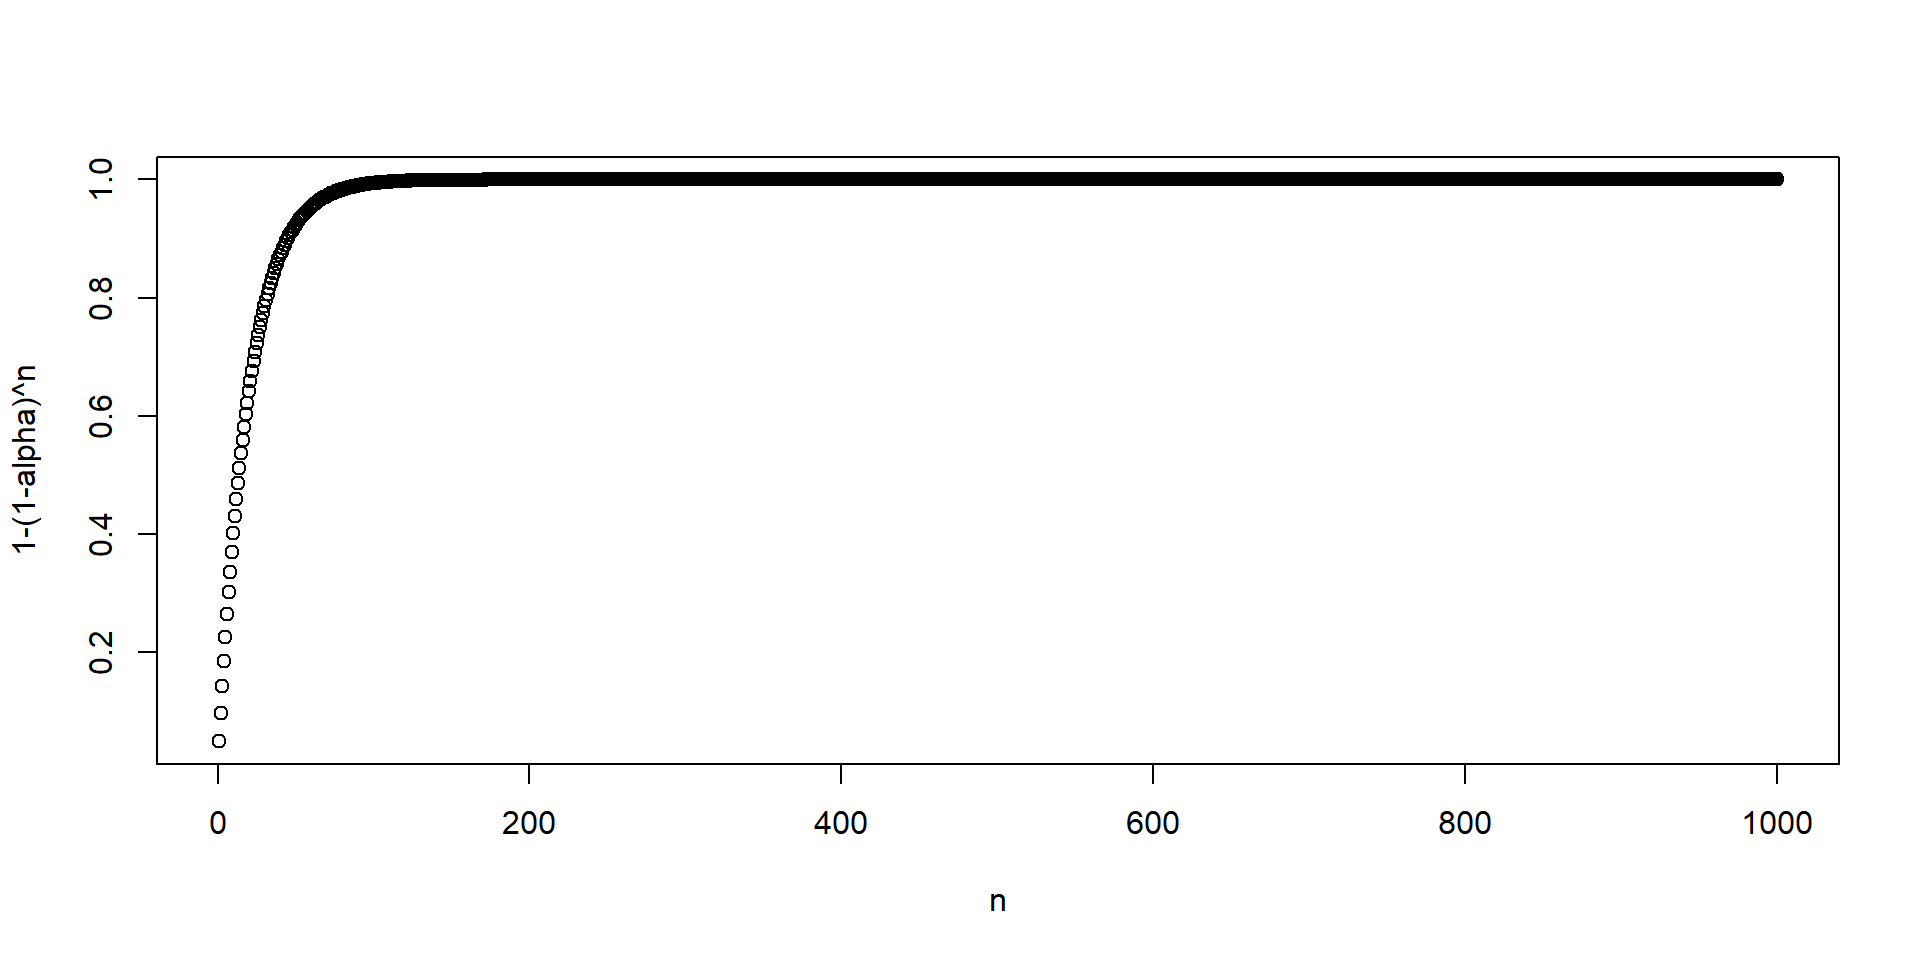
Si realizamos \(n\) pruebas, la probabilidad de no cometer un error es \((1-\alpha)^n\) y la probabilidad de cometer al menos un error es \(1-(1-\alpha)^n\)
Es decir, la probabilidad de cometer al menos un error crece rápidamente y se acerca a 1
Hipótesis múltiples
- Dos estrategias que abordaremos son:
- Controlar o ajustar \(\alpha\)
- Crear índices que agreguen varias variables
Control del error tipo I
Control del error tipo I
- Shaffer (1995), Multiple Hypothesis Testing
- Definimos familias de variables
- Haremos el ajuste hacia adentro de estas familias
- Antes habíamos estudiado en Banerjee et al. (2015)
- Seguridad alimentaria
- Consumo
- Activos
- Salud mental
- Dentro de cada familia tenemos \(n\) hipótesis \(H_i\), con un valor \(p\) asociado \(p_i\)
- Recordemos que \(p_i\) se define como la probabilidad de observar un estadístico al menos tan extremo como el observado, bajo la \(H_0\)
- Ordenamos las hipótesis de menor a mayor, con \(p_1\) siendo el valor más pequeño: \(p_1\leq p_2\ldots \leq p_n\)
Método de Bonferroni
- El método propuesto por Bonferroni controla la tasa de error por familia (FWER por family-wise error rate) definida como la probabilidad de cometer al menos un error tipo I
Consiste en rechazar \(H_i\) si \(p_i\leq \alpha_i\), donde \(\alpha_i\) se escoge de forma que \(\sum_i\alpha_i=\alpha\)
Usualmente se hace \(\alpha_i=\frac{\alpha}{n}\)
- Por ejemplo, con dos pruebas y \(\alpha=0.05\), \(\alpha_i^B=0.025\)
- Noten que esta corrección es bastante conservadora
- De forma equivalente, podemos ver este método como crear unos valores \(p^B\) ajustados: \(p_i^B=\min(p_i\times n,1)\)
¿Por qué preocuparnos por la FWER?
La idea de la FWER tiene sentido si nos preocupa tener incluso un solo falso positivo
En la práctica, podemos vivir con algunos falsos positivos
Método de Benjamini y Hochberg
Este método controla la tasa de falso descubrimiento
Si \(V\) es el número de falsos rechazos (cuando rechazamos la \(H_0\) que es verdadera) y si \(R\) es el número total de rechazos, entonces \(Q=V/R\) es la proporción de falsos rechazos (por convención \(Q=0\) si \(R=0\))
Al valor esperado de \(Q\) se le conoce como tasa de falso descubrimiento (FDR por false discovery rate)
Sea \(k\) el más grande de los \(i\) tal que \[p_i\leq\frac{i}{n}\alpha\] entonces rechazar todos los \(H_i\) para \(i=1,2,\ldots,k\)
En la práctica usamos algún software para programar algoritmos o funciones ya definidas
Ejemplo
- Consideremos las siguientes hipótesis (ya ordenadas) de Benjamini & Hochberg (1995)
Ejemplo: Bonferroni
# A tibble: 15 × 4
   poriginal hipotesis bonferroni_alpha bonferroni_rechazar
       <dbl>     <dbl>            <dbl>               <dbl>
 1    0.0001         1          0.00333                   1
 2    0.0004         2          0.00333                   1
 3    0.0019         3          0.00333                   1
 4    0.0095         4          0.00333                   0
 5    0.0201         5          0.00333                   0
 6    0.0278         6          0.00333                   0
 7    0.0298         7          0.00333                   0
 8    0.0344         8          0.00333                   0
 9    0.0459         9          0.00333                   0
10    0.324         10          0.00333                   0
11    0.426         11          0.00333                   0
12    0.572         12          0.00333                   0
13    0.653         13          0.00333                   0
14    0.759         14          0.00333                   0
15    1             15          0.00333                   0
Ejemplo: Benjamini & Hochberg
# A tibble: 15 × 6
   poriginal hipotesis bh_alpha cumple     k bh_rechazar
       <dbl>     <dbl>    <dbl> <lgl>  <dbl>       <dbl>
 1    0.0001         1  0.00333 TRUE       4           1
 2    0.0004         2  0.00667 TRUE       4           1
 3    0.0019         3  0.01    TRUE       4           1
 4    0.0095         4  0.0133  TRUE       4           1
 5    0.0201         5  0.0167  FALSE      4           0
 6    0.0278         6  0.02    FALSE      4           0
 7    0.0298         7  0.0233  FALSE      4           0
 8    0.0344         8  0.0267  FALSE      4           0
 9    0.0459         9  0.03    FALSE      4           0
10    0.324         10  0.0333  FALSE      4           0
11    0.426         11  0.0367  FALSE      4           0
12    0.572         12  0.04    FALSE      4           0
13    0.653         13  0.0433  FALSE      4           0
14    0.759         14  0.0467  FALSE      4           0
15 1 15 0.05 FALSE 4 0- \(k\) es un solo número para toda la familia, es decir, rechazamos todo hasta \(k\), no hipótesis por hipótesis
Los mismos resultados con p.adjust
- En lugar de comparar cada \(p_i\) contra su umbral,
p.adjustdevuelve los valores \(p\) ajustados, que comparamos contra \(\alpha\)
# A tibble: 15 × 6
   poriginal hipotesis p_bonferroni   p_bh rech_bonferroni rech_bh
       <dbl>     <dbl>        <dbl>  <dbl>           <dbl>   <dbl>
 1    0.0001         1       0.0015 0.0015               1       1
 2    0.0004         2       0.006  0.003                1       1
 3    0.0019         3       0.0285 0.0095               1       1
 4    0.0095         4       0.142  0.0356               0       1
 5    0.0201         5       0.302  0.0603               0       0
 6    0.0278         6       0.417  0.0639               0       0
 7    0.0298         7       0.447  0.0639               0       0
 8    0.0344         8       0.516  0.0645               0       0
 9    0.0459         9       0.688  0.0765               0       0
10    0.324         10       1      0.486                0       0
11    0.426         11       1      0.581                0       0
12    0.572         12       1      0.715                0       0
13    0.653         13       1      0.753                0       0
14    0.759         14       1      0.813                0       0
15 1 15 1 1 0 0- Bonferroni rechaza tres hipótesis y BH rechaza cuatro, exactamente lo que obtuvimos a mano
Índices
Índice de Kling, Liebman y Katz
Otra forma comúnmente usada de evitar el problema de las múltiples hipótesis es crear índices
Kling, Liebman y Katz (2007) proponen el siguiente promedio de los \(z\)-score para generar un solo índice
Definir las familias y las variables o indicadores que componen cada familia, donde \(y_{ij}\) es la \(j\)-ésima variable en la familia con \(J\) variables
Definir las variables \(y_{ij}\) de tal forma que mayores valores se interpreten como mejora
Crear \(z_{ij}\) como \(z_{ij}=\frac{y_{ij}-\bar{y}_j^C}{sd(y_j)^C}\sim(0,1)\), es decir, estandarizar cada una de las \(J\) variables usando al grupo de control como referencia, de modo que en ese grupo tenga media 0 y varianza 1
Crear \(z_i\), un solo índice para cada individuo que agregue los \(J\) \(z\)-scores creados antes
El procedimiento descrito en Banerjee et al. (2015) es bastante general, pues incluye el caso donde hay varias rondas de seguimiento y varios países
Índice de Kling, Liebman y Katz
- Podemos escribir el índice descrito como
\[z_i=\frac{\bar{z}_i-\overline{\bar{z}}^C}{sd(\bar{z}^C)}\] donde \(\bar{z}_i=\frac{1}{J}\sum_{j=1}^{J} z_{ij}\) y \(\overline{\bar{z}}^C\) y \(sd(\bar{z}^C)\) son la media y la desviación estándar de \(\bar{z}_i\) en el grupo de control
- Esta transformación tiene la ventaja de que en la siguiente regresión de efecto de tratamiento
\[z_i=\phi+\beta T_i + X_i'\gamma+\varepsilon_i\]
el coeficiente \(\beta\) se interpreta como el efecto del tratamiento expresado en desviaciones estándar del grupo de control (\(\beta=0.2\) significa que el tratamiento mueve el índice 0.2 desviaciones estándar)
Noten que todas las variables dentro de la familia pesan igual
Quizás nos gustaría tomar en cuenta la correlación entre las variables dentro del índice
Índice de Anderson
- Anderson (2008) propone el siguiente índice, que puede verse como una generalización del de Kling:
\[\bar{s}_i=\frac{1}{W_{i}}\sum_{j\in J_i} w_{j} z_{ij}\]
donde \(w_{j}\) es el peso para la variable o indicador \(j\) y \(W_i=\sum_{j\in J_i}w_{j}\), con \(J_i\) el conjunto de variables observadas para el individuo \(i\)
\(w_{j}\) es la suma de la \(j\)-ésima fila de \(\Sigma^{-1}\), la inversa de la matriz de covarianzas de \(z_{ij}\)
Es más eficiente que el índice de Kling al otorgar menor peso a las variables más correlacionadas entre sí
Usa toda la información disponible pues las variables faltantes simplemente se ignoran y los pesos restantes se renormalizan, de modo que las variables con menos valores faltantes terminan pesando más
En la práctica, \(\bar{s}_i\) puede estandarizarse con respecto al grupo de control para facilitar su interpretación
Índice de Anderson
- Anderson (2008) muestra que podemos calcular \(\bar{s}_i\) como:
\[\bar{s}_i=(\mathbf{1}'\Sigma^{-1}\mathbf{1})^{-1}(\mathbf{1}'\Sigma^{-1}\mathbf{z}_{i})\] donde \(\mathbf{1}\) es un vector columna de unos y \(\mathbf{z}_i\) es un vector columna de las variables estandarizadas de \(i\)
- Esta expresión funciona cuando no hay valores faltantes, pero es también fácil extender el resultado cuando hay valores faltantes
Hipótesis múltiples
Inferencia Causal
CIDE · Maestría en Economía
© 2026 Irvin Rojas. Distribuido bajo licencia Creative Commons CC BY-NC-SA 4.0. Los materiales de terceros citados conservan sus propios derechos.
Inferencia Causal · Hipótesis múltiples